KI
Das KI-Stack verstehen und wo sich Xinity einfügt
Die meisten Organisationen, die KI einführen, sind sich nicht bewusst, auf wie vielen Ebenen sie aufbauen. Jede Ebene ist eine Abhängigkeit, eine Kostenstelle und ein Kontrollpunkt. Wenn Sie diese Ebenen kartieren, können Sie sehen, wovon Sie tatsächlich abhängen. Sie können auch sehen, wo Xinity Souveränität bietet.
Die fünf Ebenen des KI-Stacks
Ebene 1: Hardware-Infrastruktur
Was es ist: die physische Rechenleistung hinter KI-Workloads. Das bedeutet GPUs für parallele Verarbeitung, KI-Beschleuniger, Hochleistungs-CPUs, Arbeitsspeicher, Speicher und Netzwerke.
Traditionelle Kontrolle: Cloud-Anbieter besitzen und betreiben riesige Rechenzentren. Ihre Workloads laufen auf deren Hardware, in deren Einrichtungen, unter deren physischer Kontrolle.
Die Abhängigkeit: Sie mieten Rechenzeit, besitzen aber nie die Infrastruktur. Die Kosten steigen unbegrenzt mit der Nutzung. Sie sind von der Verfügbarkeit, Preisänderungen und Servicebedingungen abhängig. Der physische Verarbeitungsort liegt außerhalb Ihrer Kontrolle.
Ebene 2: Systemsoftware & Runtime
Was es ist: die Software, die Ihre Hardware verwaltet. Betriebssysteme, Container-Orchestrierung wie Docker und Kubernetes, GPU-Treiber, CUDA-Bibliotheken, Ressourcen-Scheduling und Sicherheitsebenen.
Traditionelle Kontrolle: Cloud-Anbieter konfigurieren und warten diese Systeme. Sie erhalten nur begrenzten Zugriff über APIs. Updates, Patches und Konfigurationen werden extern verwaltet.
Die Abhängigkeit: Eingeschränkte Sichtbarkeit der Systemkonfiguration. Keine Anpassung von Low-Level-Optimierungen möglich. Abhängig von den Sicherheitspraktiken und der Compliance auf Systemebene des Anbieters.
Ebene 3: KI-Modellbereitstellung & Orchestrierung
Was es ist: die Ebene, die Modelle lädt, Anfragen verarbeitet und die Inferenz verwaltet. Sie umfasst den Modellstart, das Request-Routing, die GPU-Zuweisung, das Caching, das Tuning, API-Gateways und das Monitoring.
Traditionelle Kontrolle: Cloud-KI-Anbieter verpacken dies als Blackbox. Sie senden Anfragen, diese liefern Ergebnisse. Keine Sichtbarkeit darüber, wie Modelle geladen, gecacht oder optimiert werden.
Die Abhängigkeit: Keine Optimierung für Ihre spezifischen Workload-Muster möglich. Keine benutzerdefinierte Routing-Logik. Beschränkt auf die vom Anbieter unterstützten Modelle. Intransparente Leistungsmerkmale.
🎯 Hier setzt Xinity an
Xinity stellt die Orchestrierungsebene zwischen Ihren Anwendungen und KI-Modellen bereit und bietet Ihnen:
Vollständige Kontrolle über die Infrastruktur zur Modellbereitstellung
Intelligentes Routing über mehrere Modelle und GPUs hinweg
Individuelle Optimierung für Ihre Workload-Muster
Volle Sichtbarkeit der Leistung und Ressourcennutzung
OpenAI-kompatible APIs für eine nahtlose Integration
Ebene 4: KI-Modelle
Was es ist: die neuronalen Netze selbst. Basismodelle wie LLMs und Vision-Modelle, feingetunte Modelle, spezialisierte Domänenmodelle, Embeddings und multimodale Modelle.
Traditionelle Kontrolle: Cloud-Anbieter bieten Zugriff auf proprietäre Modelle, die Sie nutzen, aber nicht besitzen können. Modellgewichte und -architekturen sind oft geschlossen. Feintuning kann eingeschränkt oder teuer sein.
Die Abhängigkeit: Keine Einsicht in die Interna des Modells möglich. Eingeschränkte Anpassungsmöglichkeiten. Modell-Updates erfolgen nach dem Zeitplan des Anbieters. Die Preisgestaltung ist an die Komplexität des Modells gekoppelt.
Wie Xinity dies löst:
Stellen Sie jedes beliebige Open-Source-Modell Ihrer Wahl bereit
Führen Sie individuell feingetunte Modelle auf Ihren Daten aus
Volles Eigentum an Modellgewichten und Trainingsdaten
Freiheit, mit modernsten Open-Source-Modellen zu experimentieren
Keine Einschränkungen bei Modifikation oder Spezialisierung
Ebene 5: Anwendungen & Schnittstellen
Was es ist: die Apps und APIs, mit denen Ihre Benutzer tatsächlich interagieren. Chat-Schnittstellen, Dokumentenverarbeitung, Codegenerierung, Kundenservice-Bots, Analyse-Tools und Ihre eigenen Geschäftsanwendungen.
Traditionelle Kontrolle: Sie entwickeln die Anwendung, aber sie ist eng an spezifische Cloud-KI-APIs gekoppelt. Ein Anbieterwechsel bedeutet, Code neu zu schreiben.
Wie Xinity dies löst:
OpenAI-kompatible API bedeutet, dass Ihre Anwendungen unverändert funktionieren
Einfacher Austausch durch Ändern der Basis-URL und des API-Schlüssels
Kein Vendor-Lock-in auf der Anwendungsebene
Freiheit, Modelle zu wechseln oder aus mehreren Quellen zu beziehen
Der Stack-Vergleich
Traditionelle Cloud-KI: Versteckte Abhängigkeiten
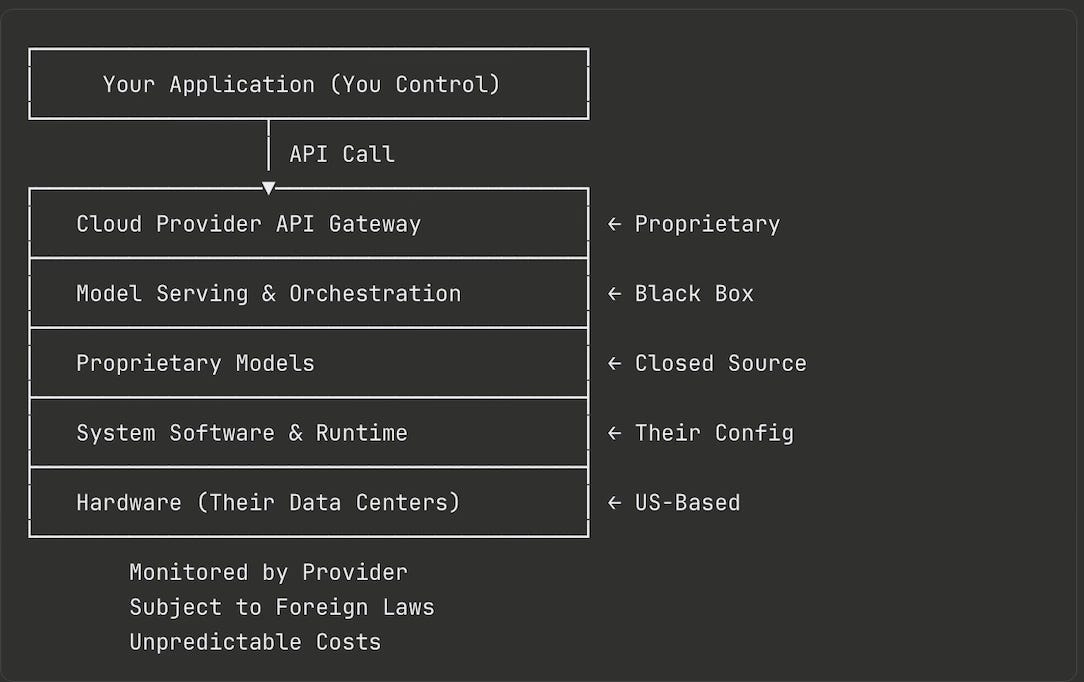
Sie kontrollieren: Ihren Anwendungscode
Sie kontrollieren nicht: Alles andere – Monitoring, Gerichtsbarkeit, Kosten, Konfiguration
Xinity Sovereign AI Stack: Volle Kontrolle
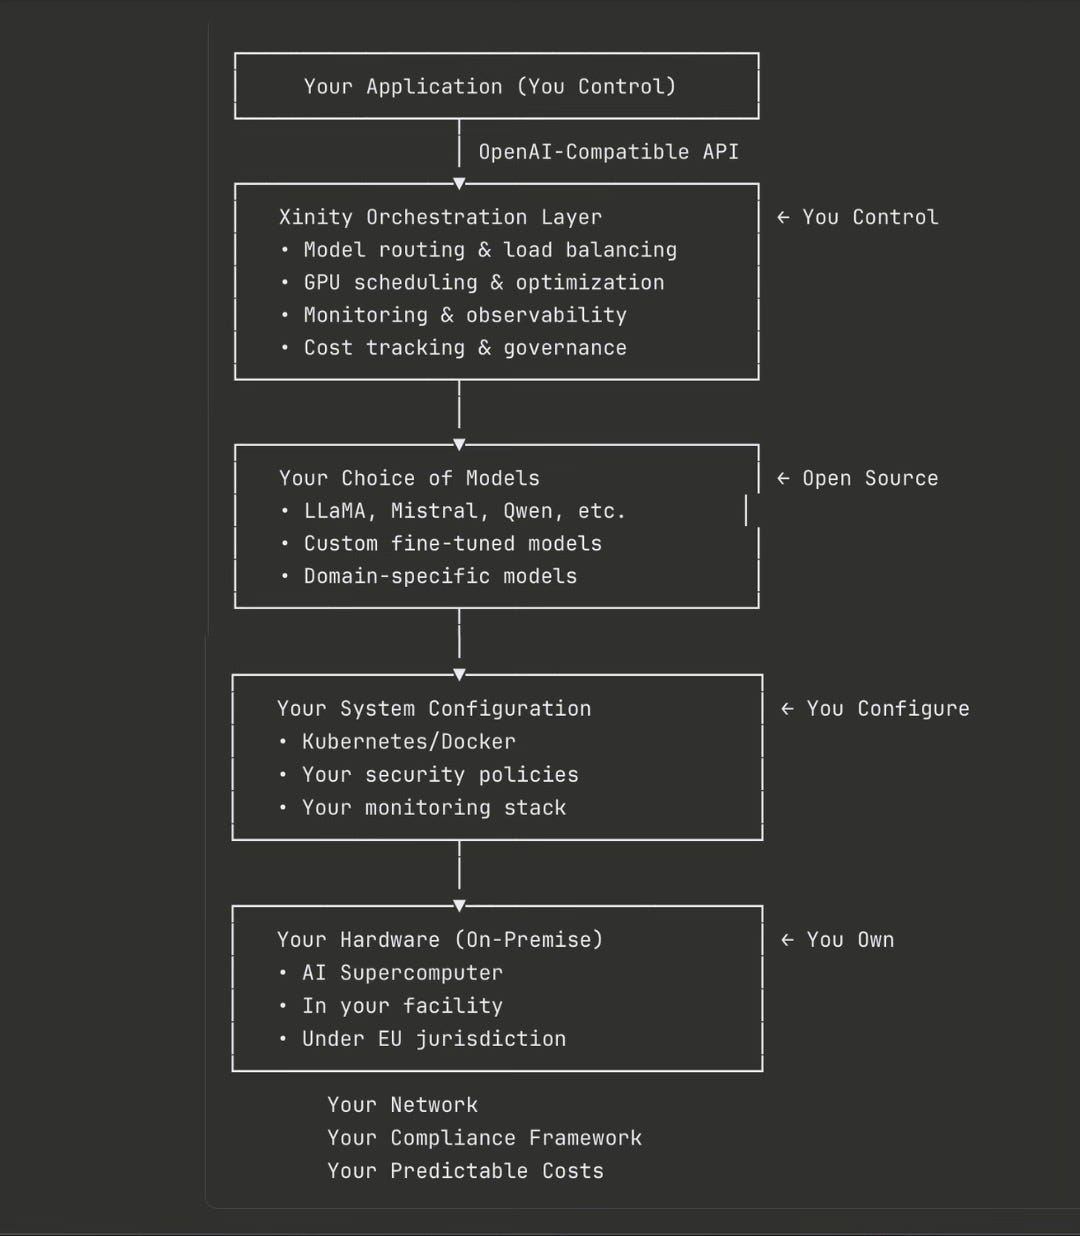
Sie kontrollieren: Alles von der Hardware aufwärts
Was Xinity bietet: Die intelligente Orchestrierungsebene, die dafür sorgt, dass alles nahtlos funktioniert
Das Problem, das Xinity löst
Die falsche Wahl
Die meisten Organisationen stehen vor zwei schlechten Optionen:
Option A: Cloud-KI-Dienste
✅ Einfach zu bedienen mit einfachen APIs
✅ Keine Infrastrukturverwaltung
❌ Daten verlassen Ihre Kontrolle
❌ Unvorhersehbare, skalierende Kosten
❌ Vendor-Lock-in
❌ Unterliegt ausländischer Gerichtsbarkeit
Option B: Alles selbst bauen
✅ Volle Kontrolle über die Infrastruktur
✅ Daten bleiben lokal (on-premise)
❌ Erfordert mehr als 12 Monate Entwicklung
❌ Tiefgehendes ML-Engineering-Fachwissen erforderlich
❌ Komplexe Infrastruktur für die Modellbereitstellung
❌ Laufender Wartungsaufwand
Xinity: Der dritte Weg
✅ Cloud-ähnliche Einfachheit mit OpenAI-kompatiblen APIs
✅ Volle Datensouveränität auf Ihrer Hardware
✅ In Tagen statt Monaten einsatzbereit
✅ Kein ML-Engineering-Fachwissen erforderlich
✅ Vorhersehbare, infrastrukturabhängige Kosten
✅ Europäische Gerichtsbarkeit und DSGVO-Konformität
Was die Orchestrierung von Xinity unverzichtbar macht
1. Intelligentes Modell-Routing
Nicht jede Anfrage benötigt Ihr leistungsstärkstes Modell. Xinity leitet Anfragen basierend auf der Komplexität der Abfrage, der erforderlichen Qualität, den verfügbaren GPU-Ressourcen, Budgetbeschränkungen und Latenzanforderungen weiter.
Tatsächlicher Nutzen: Einfache Faktenabfragen werden an kleinere, schnellere Modelle weitergeleitet, während komplexe logische Aufgaben Ihr leistungsfähigstes Modell nutzen – was sowohl die Leistung als auch die Kosten optimiert.
2. GPU-Ressourcenoptimierung
GPUs sind teuer. Xinity maximiert den Wert durch On-Demand-Modellladung, Request-Batching, workloadbasierte Zuweisung und die Vermeidung von Ressourcenkonflikten.
Tatsächlicher Nutzen: Erzielen Sie im Vergleich zu herkömmlichen Implementierungen einen 3- bis 5-mal höheren Inferenz-Durchsatz auf derselben Hardware.
3. Zuverlässigkeit auf Enterprise-Niveau
Unternehmens-KI benötigt Zuverlässigkeit auf Enterprise-Niveau: automatisches Failover, Systemüberwachung mit automatischer Wiederherstellung, Warteschlangen für Anfragen bei hoher Auslastung und Strategien für einen kontrollierten Leistungsabbau (graceful degradation).
Tatsächlicher Nutzen: Ihre Anwendungen bleiben auch dann reaktionsfähig, wenn einzelne Komponenten ausfallen.
4. Observability & Governance
Umfassende Transparenz durch Logging und Tracing auf Anfrageebene, Kostenzuordnung nach Team oder Projekt, Leistungskennzahlen und Engpasserkennung sowie Audit-Trails für die Compliance.
Tatsächlicher Nutzen: Wissen Sie genau, wohin die KI-Ressourcen fließen, und weisen Sie Compliance gegenüber Auditoren lückenlos nach.
5. Reibungslose Migration
Die OpenAI-kompatible API bedeutet, dass Sie lediglich zwei Zeilen Code (Basis-URL und API-Schlüssel) ändern müssen. Bestehendes Prompt-Engineering bleibt erhalten, aktuelle Workflows werden fortgeführt und es ist keine Teamschulung erforderlich.
Tatsächlicher Nutzen: Migrieren Sie Produktionsanwendungen in Stunden statt Monaten.
Anwendungsfälle: Wo Xinity am wichtigsten ist
Unternehmen mit mehreren Teams
Herausforderung: Verschiedene Teams nutzen KI unabhängig voneinander, keine Kostentransparenz, Ressourcenkonflikte
Xinity-Lösung: Zentralisierte Steuerungsebene (Control Plane), Quoten und Richtlinien pro Team, gemeinsam genutzte GPU-Infrastruktur mit fairer Zeitplanung (Scheduling), einheitliche Abrechnung und Kostenzuordnung
Regulierte Branchen
Herausforderung: Benötigen KI-Funktionen, können aber aufgrund von Compliance-Vorschriften keine Daten an Cloud-Anbieter senden
Xinity-Lösung: Vollständige Datenresidenz auf Ihrer Hardware, lückenlose Audit-Trails, Compliance-ready (DSGVO, branchenspezifische Regulierungen), nachvollziehbares Routing und Entscheidungsfindung
Kostensensible Implementierungen
Herausforderung: Cloud-KI-Kosten explodieren mit steigender Nutzung, Bedarf an Kostenvorhersehbarkeit
Xinity-Lösung: Infrastrukturbasierte Preisgestaltung (nicht pro Token), intelligentes Routing zur Minimierung der Rechenleistung, vollständige Kostentransparenz, 70–90 % Kostenreduktion im Vergleich zur Cloud
Eigene Modellbereitstellungen
Herausforderung: Notwendigkeit, feingetunte oder domänenspezifische Modelle auszuführen, die von Cloud-Anbietern nicht angeboten werden
Xinity-Lösung: Bereitstellung jedes beliebigen Open-Source-Modells, Ausführung individuell feingetunter Modelle, A/B-Tests mehrerer Versionen, schrittweise Einführung von Updates
Warum die Orchestrierungsebene entscheidend ist
Das Ausführen von KI-Modellen auf eigener Hardware reicht für souveräne KI nicht aus. Sie benötigen:
Eine intelligente Ebene, die Ihre Ressourcen optimal nutzt
Zuverlässigkeit auf Enterprise-Niveau, die Unternehmen voraussetzen
Entwicklerfreundliche APIs, die eine schnelle Migration ermöglichen
Observability und Governance für Compliance und Optimierung
Diese Orchestrierungsebene ist komplex aufzubauen – Cloud-Anbieter haben Jahre benötigt, um ihre zu entwickeln. Xinity bringt genau diese Professionalität in On-Premise-Installationen und macht souveräne KI für Organisationen praktisch nutzbar, die Kontrolle ohne Komplexität benötigen.
Xinity liefert Ihnen nicht nur Infrastruktur. Es liefert das fehlende Puzzleteil, mit dem souveräne KI in der Praxis tatsächlich funktioniert.
Bereit, Xinity in Aktion zu sehen?
Erfahren Sie, wie Xinity cloud-ähnliche KI-Funktionen auf Ihre On-Premise-Infrastruktur bringen kann.