Souveräne KI
Kostet Sie ein Sovereign AI Gateway Geschwindigkeit?
Jedes Team, das On-Premise-KI evaluiert, stellt sich dieselbe Frage. Ein Gateway, das Authentifizierung, Anfragezulassung (Admission Control), Wiederholungsversuche (Retries) und Observability hinzufügt, klingt nach Overhead. Overhead klingt nach Latenz. Macht das Vorschalten einer Enterprise-Ebene vor das Modell dieses also langsamer?
Wir haben es gemessen – und den Test so konzipiert, dass er zu unseren Ungunsten ausfällt.
Wichtigste Erkenntnisse
Auf identischer Hardware und mit denselben Modellgewichten erreichte das Xinity-Gateway bei der Token-Rate pro Stream die gleiche Geschwindigkeit wie das reine vLLM und übertraf es beim maximalen Gesamtdurchsatz.
Bei 512 gleichzeitigen Nutzern mit Prompts von 65.536 Token schloss Xinity 85,0 % der Anfragen erfolgreich ab. Das reine vLLM schaffte lediglich 4,6 %.
Das bedeutet, dass unter extremer Last – dem Punkt, an dem ein unmanaged Server kapituliert – bis zu 18-mal mehr Anfragen erfolgreich abgeschlossen werden.
Die einzigen Kosten dafür sind etwa 56 ms zusätzliche Zeit bis zum ersten Token (Time to First Token), was auf den Netzwerkpfad und nicht auf das Modell zurückzuführen ist.
Das Gateway lief über das öffentliche Internet mit WireGuard und TLS. Das reine vLLM lief über Loopback ganz ohne Netzwerk. Wir haben dennoch gewonnen.
Der ehrliche Test
Die Versuchung bei einem herstellerseitigen Benchmark besteht darin, die Bedingungen zu den eigenen Gunsten zu beeinflussen. Wir haben sie in die andere Richtung gelenkt.
Beide Durchläufe nutzten dieselbe Benchmark-Umgebung, dieselbe Hardware und dieselben Modellgewichte. Die einzige Variable war der Netzwerkpfad.
Xinity-Gateway: Die Anfragen liefen über das öffentliche Internet, durch einen WireGuard-Tunnel und anschließend über eine TLS-Terminierung. Das entspricht etwa 60 IP-Hops, bevor ein Token generiert wurde.
Reines vLLM: Die Anfragen trafen das Modell über Loopback. Localhost. Keinerlei Netzwerk im Weg.
Wenn ein Gateway die Geschwindigkeit beeinträchtigt, bringt dieses Setup das ans Licht. Wir haben der Baseline jeden Vorteil verschafft und uns selbst absichtlich gehandicapt.
Das Setup
Hardware: 1x NVIDIA DGX Spark, 128 GB
Modell: Qwen 3.6-35B-A3B-FP8
Szenarien: 120, bestehend aus 5 Input-Größen, 3 Output-Größen und 8 Concurrency-Stufen (Gleichzeitigkeit)
Prompt-Größe: 256 bis 65.536 Token
Output-Länge: 64 bis 2.048 Token
Concurrency: 1 bis 512 aktive Anfragen gleichzeitig
Volumen: 31.200 Anfragen pro Durchlauf
Die Ergebnisse
Metrik | Xinity-Gateway | Reines vLLM (Loopback) |
|---|---|---|
Zeit bis zum ersten Token, p50 / p95 | 321 / 512 ms | 265 / 269 ms |
Generierungsrate pro Stream, p50 | 50,0 Tok/s | 50,0 Tok/s |
Maximaler Gesamtdurchsatz | 352 Tok/s | 325 Tok/s |
Maximal validierte Kontextlänge | 262.144 Token | 262.144 Token |
Erfolgsquote bei 512 gleichzeitigen Anfragen, 65k Prompts | 85,0 % (870 / 1024) | 4,6 % (47 / 1024) |
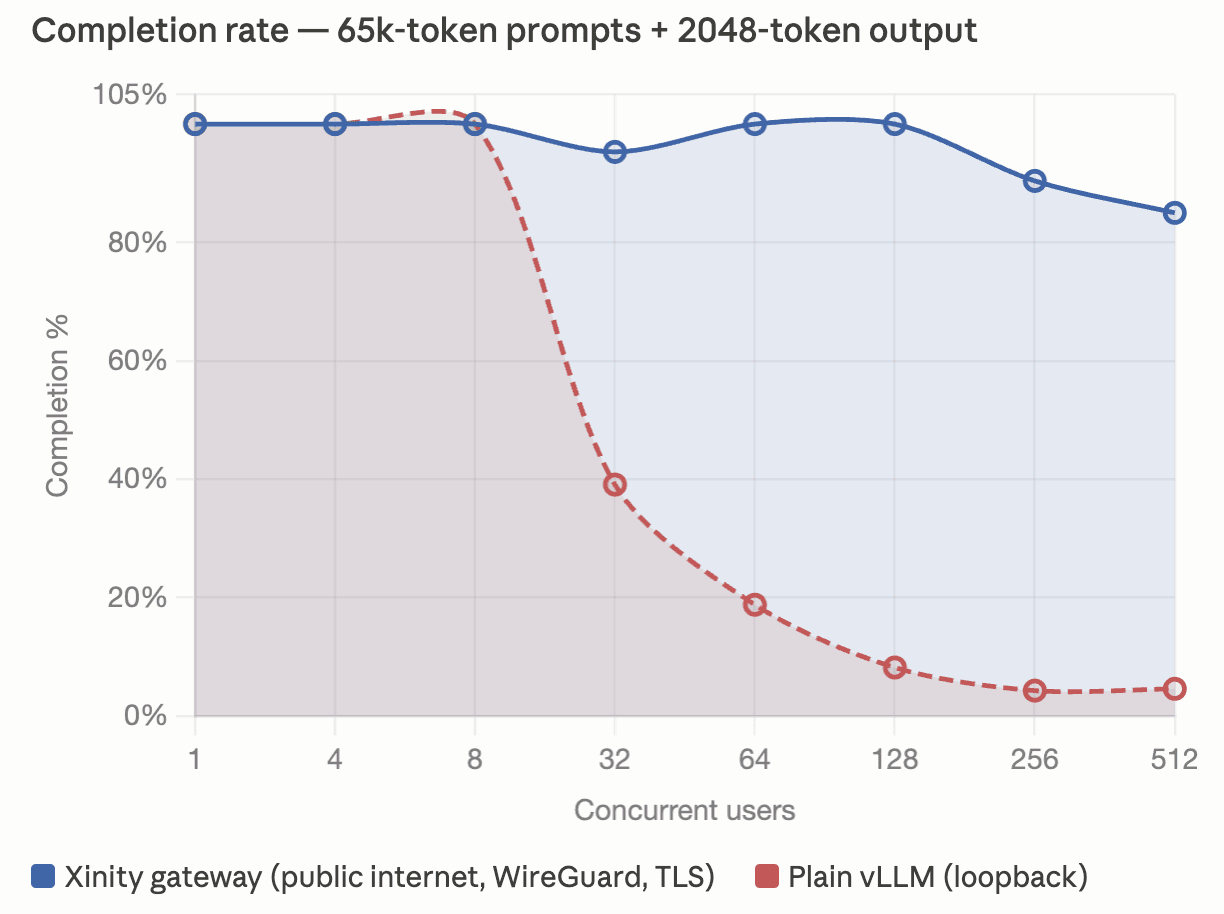
Die entscheidende Zeile ist die Erfolgsquote unter Last. Beide Systeme bedienen einzelne Streams mit derselben Geschwindigkeit. Der Unterschied zeigt sich, wenn das System ausgelastet ist. Das reine vLLM hält bis zu etwa 8 gleichzeitigen Nutzern stand und stürzt dann drastisch ab. Xinity bleibt über den gesamten Weg bis hin zu 512 Nutzern fast ganz oben in der Grafik.
Warum ist das Gateway unter Last schneller und nicht langsamer?
Das ist der kontraintuitive Teil, daher hier der Mechanismus in einfachen Worten erklärt.
Die Verzögerung beim ersten Token liegt nur am Netzwerk
Die Differenz von 56 ms bei der Zeit bis zum ersten Token ist der Roundtrip über das öffentliche Internet, WireGuard und TLS. Das sind die Kosten des Netzwerkpfades, nicht der Gateway-Logik. Sobald die Generierung startet, ist die Token-Rate pro Stream mit 50,0 Tok/s absolut identisch.
Begrenzte Anfragezulassung hält den Scheduler stabil
Der maximale Gesamtdurchsatz ist über das Gateway höher, da eine kontrollierte Anfragezulassung (Admission Control) den Scheduler von vLLM in seinem effizienten Betriebsbereich hält. Ein unmanaged Server akzeptiert alles auf einmal, fängt an zu „thrashren“ (seitenweise Aus- und Einlagern bzw. Überlastung) und sein effektiver Durchsatz bricht ein. Die Zulassungskontrolle ist hier kein Overhead. Sie sorgt erst dafür, dass die Hardware ihre Arbeit machen kann.
Transparente Wiederholungen fangen Fehler ab, bevor der Client sie bemerkt
Unter anhaltender Überlastung beginnt das bloße vLLM, fehlerhafte Streaming-Chunks auszugeben. Der Client sieht Stream-Parsing-Fehler und die Anfrage schlägt fehl. Das Xinity-Gateway fängt diese intern ab und sendet sie erneut, noch bevor der Fehler den Aufrufer erreicht. Das ist der Unterschied zwischen einer Erfolgsquote von 4,6 % und 85,0 %.
Das Ergebnis ist ein System, das in der Produktion nutzbar bleibt, anstatt bei der ersten Traffic-Spitze in die Knie zu gehen.
Was das für regulierte Branchen bedeutet
Wenn Sie KI im Finanzwesen, im Gesundheitswesen, im Rechtsbereich oder im öffentlichen Sektor einsetzen, ist die interessante Zahl nicht die Anzahl der Token pro Sekunde auf einem System im Leerlauf. Es ist die Anzahl der erfolgreich abgeschlossenen Anfragen, wenn am Montag um 9 Uhr morgens alle Nutzer gleichzeitig auf das System zugreifen.
Ein Modell, das isoliert betrachtet schnell ist, aber unter Last 95 % der Anfragen fallen lässt, ist kein produktionsreifes System. Es ist eine Demo. Die Gateway-Ebene macht aus der reinen Inferenz ein System, das Sie echten Nutzern auf Ihrer eigenen Hardware zur Verfügung stellen können, ohne Daten in die Cloud eines Drittanbieters senden zu müssen.
Das ist es, was wir unter „souverän durch Architektur, nicht durch Verträge“ verstehen. Die Kontrolle liegt in der Infrastruktur, nicht in einer Datenverarbeitungsvereinbarung.
Ehrliche Einschränkungen
Wir möchten lieber, dass Sie den Zahlen vertrauen, als dass Sie später von ihnen überrascht werden.
Die Zeit bis zum ersten Token ist über das Gateway um etwa 56 ms langsamer. Für ein System im öffentlichen Internet im Vergleich zu einem im Loopback ist das zu erwarten und minimal. Wenn Ihre Arbeitslast aus vielen winzigen, einmaligen Prompts ohne Gleichzeitigkeit besteht, wird sich das reine vLLM auf derselben Maschine beim ersten Token geringfügig reaktionsschneller anfühlen.
„Bis zu 18x“ beschreibt den Extremfall. Gemessen wurde dies bei 512 gleichzeitigen Nutzern mit Prompts von 65.536 Token – dem anspruchsvollsten Szenario des Tests. Bei geringer Gleichzeitigkeit liegen die beiden Systeme eng beieinander, da noch keine Überlastung vorliegt. Das Gateway zeigt seine Stärken, wenn die Last steigt.
Dies ist ein Vergleich der Netzwerkpfade. Wir haben absichtlich eine einzige Variable isoliert. Das ist ein fairer Weg, um die Frage „Kostet das Gateway Geschwindigkeit?“ zu beantworten – und die Antwort lautet Nein.
Häufig gestellte Fragen (FAQ)
Reduziert das Vorschalten eines Enterprise-Gateways vor vLLM die Inferenzgeschwindigkeit? Nein. In unserem Benchmark war die Token-Generierungsrate pro Stream mit 50,0 Tok/s identisch, und der maximale Durchsatz war über das Gateway sogar höher. Die einzigen messbaren Kosten waren etwa 56 ms zusätzliche Zeit bis zum ersten Token, was auf den Netzwerkpfad zurückzuführen ist.
Wie hoch ist der Unterschied bei der Erfolgsquote zwischen Xinity und dem reinen vLLM unter Last? Bei 512 gleichzeitigen Nutzern mit Prompts von 65.536 Token schloss das Xinity-Gateway 85,0 % der Anfragen ab (870 von 1024), während das reine vLLM 4,6 % (47 von 1024) erreichte – das ist in etwa das 18-Fache.
Warum scheitert ein unmanaged vLLM-Server bei hoher Gleichzeitigkeit? Ohne eine Zulassungskontrolle für Anfragen akzeptiert der Scheduler zu viele Anfragen auf einmal und verlässt seinen effizienten Betriebsbereich. Unter anhaltender Überlastung gibt er zudem fehlerhafte Streaming-Chunks aus, die beim Client als Fehler ankommen. Ein Gateway mit begrenzter Zulassung und transparenten Wiederholungsversuchen verhindert beides.
Welche Hardware und welches Modell wurden verwendet? Eine einzelne NVIDIA DGX Spark mit 128 GB, auf der Qwen 3.6-35B-A3B-FP8 lief, getestet in 120 Szenarien und mit 31.200 Anfragen pro Durchlauf.
Ist dieser Benchmark reproduzierbar? Ja. Beide Durchläufe nutzten identischen Testcode, identische Hardware und identische Modellgewichte. Der einzige Unterschied war der Netzwerkpfad. Vollständige Berichte pro Szenario und aggregierte Zusammenfassungen sind zusammen mit den Daten veröffentlicht.
Methodik und Daten
Beide Durchläufe nutzten dieselbe Benchmark-Umgebung, dieselbe DGX Spark und dieselben Qwen 3.6-35B-A3B-FP8-Gewichte. Der Xinity-Pfad lief von einem öffentlichen Endpunkt über das Internet, durch WireGuard bis zur TLS-Terminierung auf der Maschine. Der reine vLLM-Pfad lief über Loopback. Jeder Durchlauf deckte 120 Szenarien ab (5 Input-Größen mal 3 Output-Größen mal 8 Concurrency-Stufen) bei insgesamt 31.200 Anfragen.
Vollständige Berichte pro Szenario und aggregierte Zusammenfassungen sind auf Anfrage erhältlich. Wenn Sie den Test auf Ihrer eigenen Hardware durchführen möchten, stellen wir Ihnen die Testumgebung gerne zur Verfügung.
Souverän durch Architektur, nicht durch Verträge. Erfahren Sie auf xinity.ai, wie Xinity auf Ihrer Infrastruktur läuft.