Souveräne KI
NVIDIA PAIR vs. Xfinity: Router oder KI-Steuerungsebene?
NVIDIA hat eine Beta-Version des Personal AI Router, oder PAIR, veröffentlicht. Es verbindet die Maschinen, die sich bereits in Ihrem lokalen Netzwerk befinden, Windows-Systeme mit RTX-Grafikkarten, DGX Spark und neuere Macs, und bietet Ihren Anwendungen einen einzigen lokalen Endpunkt, an den sie Inferenzanfragen senden können. Es funktioniert zusammen mit Ollama und LM Studio. Für den Betrieb ist keine Internetverbindung erforderlich. Prompts, Dateien und Agenten-Kontext verbleiben im Netzwerk.
Es lohnt sich, dem Aufmerksamkeit zu schenken, und zwar aus einem Grund, der nichts mit Wettbewerb zu tun hat.
Die Debatte über lokale KI ist vorbei
Vor zwei Jahren war es noch eine Minderheitenmeinung, einem europäischen Unternehmen zu empfehlen, seine eigenen Modelle zu betreiben. Die Standardannahme war, dass ernsthafte KI einen API-Aufruf an einen US-Hyperscaler bedeutete und alles andere ein Hobby-Umweg war.
Das größte KI-Hardwareunternehmen der Welt liefert nun eine Verbraucheranwendung aus, deren Hauptverkaufsargument darin besteht, dass Ihre Daten Ihr Netzwerk nicht verlassen.
Lokale Inferenz ist nicht mehr das, was verteidigt werden muss. Dieser Teil der Diskussion ist vorbei. Was noch nicht gelöst wurde und was PAIR auch nicht zu lösen versucht, ist all das, was passiert, sobald mehr als eine Person beteiligt ist.
Was NVIDIA PAIR tatsächlich tut
Es lohnt sich, präzise zu sein, da die Marketingsprache rund um lokale KI so schwammig geworden ist, dass sehr unterschiedliche Produkte identisch klingen.
PAIR beantwortet eine Frage: Ich habe mehrere Maschinen mit GPUs in diesem Netzwerk, welche soll diese Anfrage bearbeiten?
Das ist ein Scheduling-Problem, und PAIR löst es elegant. Es entdeckt geeignete Maschinen, stellt der Anwendung einen einzigen Endpunkt zur Verfügung und leitet jede eingehende Anfrage an einen Node weiter, der freie Kapazitäten hat. NVIDIA stellt auch klar, was es nicht tut. Die Geräte bleiben separate Systeme, die an parallelen Aufgaben arbeiten. PAIR bündelt ihren Speicher nicht zu einer einzigen großen virtuellen GPU und teilt eine einzelne Anfrage nicht auf mehrere Maschinen auf. Wenn Sie eine 32-GB-Karte, eine 24-GB-Karte und einen Mac mit 64 GB gemeinsamem Speicher haben, erhalten Sie keine 120-GB-GPU. Sie erhalten drei Orte, an die Sie eine Anfrage senden können.
Für einen Entwickler mit ungenutzter Hardware im Nebenzimmer ist das wirklich nützlich. Es verwandelt brachliegende Rechenleistung in aktive Rechenleistung – ohne Verkabelung, ohne Rack und ohne Cluster-Engineering.
Die Frage, die sich eine regulierte Organisation stattdessen stellt
Nun ändern wir das Szenario. Eine Bank, ein Krankenhaus, eine Anwaltskanzlei, ein Ministerium. Die Hardware-Frage ist nicht der schwierige Teil. Sie betreiben bereits ihre eigene Infrastruktur. Der schwierige Teil ist alles rund um das Modell:
Welche Mitarbeiter und welche Anwendungen dürfen welches Modell abfragen?
Wie diese Berechtigung an bestehende Identitäts- und Verzeichnis-Systeme gekoppelt ist
Welche Aufzeichnungen im Nachhinein darüber existieren, welche Anfrage von wem an welches Modell gestellt wurde
Die Daten welcher Abteilung welchen Endpunkt berührt haben
Was Sie einer Aufsichtsbehörde vorlegen, wenn diese Sie auffordert, einen der oben genannten Punkte nachzuweisen
Nichts davon sind Routing-Fragen. Beim Routing geht es um Effizienz. Dies sind Fragen der Rechenschaftspflicht, und sie entscheiden darüber, ob ein KI-Einsatz in einem regulierten Sektor jemals produktiv genutzt wird.
Dies ist die Ebene, die Xinity aufbaut. Nicht das Modell und nicht die GPU. Die Ebene um das Modell herum: Stellen Sie Open-Weight-Modelle auf Ihren eigenen Servern bereit, regeln Sie, wer sie nutzen darf, und führen Sie Protokoll darüber, was passiert ist. Ein OpenAI-kompatibler Endpunkt, damit Ihre bestehenden Anwendungen nicht umgeschrieben werden müssen. Rollenbasierte Zugriffskontrolle und Single Sign-On (SSO), damit Berechtigungen vom selben Ort kommen wie jede andere Berechtigung im Unternehmen. Observability pro Anfrage und Audit-Protokollierung, damit die Aufzeichnungen existieren, bevor jemand danach fragt, nicht erst danach.
Wo die beiden Produkte im Stack angesiedelt sind
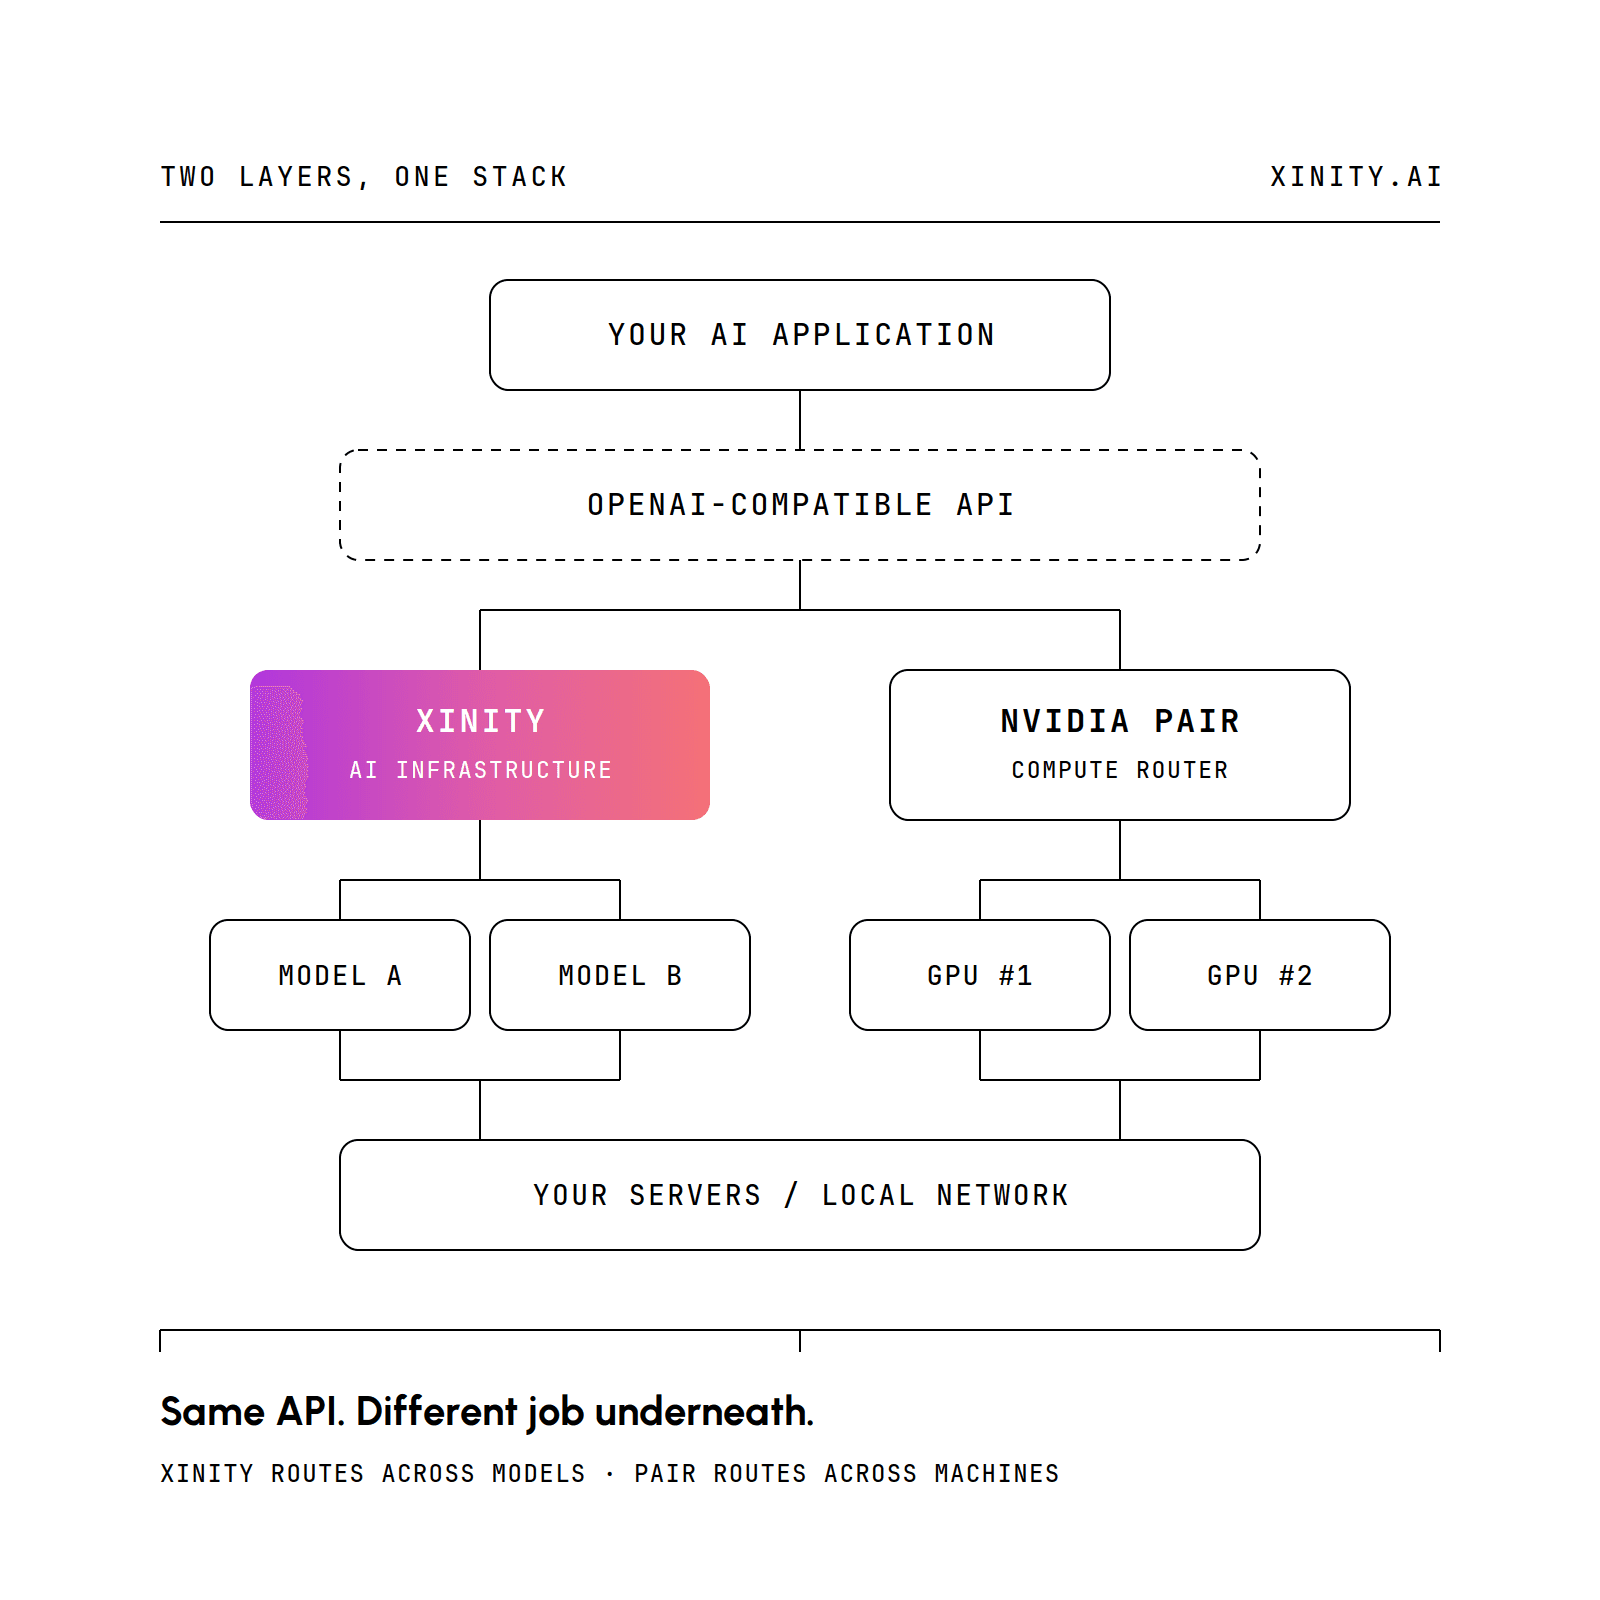
Am klarsten ausgedrückt:
NVIDIA PAIR beantwortet: Wie nutze ich die gesamte KI-Rechenleistung, die ich bereits habe?
Xinity beantwortet: Wie betreiben wir KI auf unserer eigenen Infrastruktur so, dass wir es vor einem Wirtschaftsprüfer rechtfertigen können?
Die erste Frage betrifft die persönliche Produktivität. Die zweite ist eine institutionelle Frage. Sie befinden sich auf unterschiedlichen Ebenen im selben Stack, weshalb der Vergleich eher interessant als konkurrierend ist. Im Prinzip liegt eine Steuerungsebene über einem Compute-Router: Governance und Protokollierung oben, Verteilung der Anfragen darunter. Wir haben diese Anordnung nicht getestet und behaupten nicht, dass dies eine unterstützte Konfiguration ist. Aber architektonisch gesehen konkurrieren sie nicht um denselben Platz.
Warum dies für die Planung von KI-Infrastrukturen in Europa wichtig ist
Die Lehre aus PAIR ist nicht, dass NVIDIA in einen neuen Markt eingetreten ist. Es ist, dass sich die Prämisse verschoben hat. Die Ausführung von Inferenzen auf eigener Hardware ist mittlerweile eine etablierte, vom Anbieter unterstützte Erwartung auf Verbraucherniveau.
Das bedeutet, dass sich das Unterscheidungsmerkmal verschoben hat. Wenn jeder ein Modell lokal ausführen kann, geht es nicht mehr darum, ob Ihre Daten vor Ort bleiben. Es geht darum, ob Sie nachweisen können, wer sie verwendet hat, was gefragt wurde und unter welcher Berechtigung.
Dieser Nachweis ist kein Feature, das man später hinzufügt. Er ist eine Eigenschaft der Architektur oder er ist nicht vorhanden.
Souverän durch Architektur, nicht durch Vertrag.
KI-Erklärung: Dieser Artikel wurde mit Hilfe von KI verfasst und vor der Veröffentlichung vom Xinity-Team überprüft, auf Fakten kontrolliert und bearbeitet. Alle Produktbehauptungen über Xinity spiegeln den ausgelieferten Funktionsumfang wider. Aussagen über NVIDIA PAIR stammen von NVIDIAs eigener veröffentlichter Produktseite und Dokumentation.